Email scraper : ce qu'il renvoie vraiment, et pourquoi la liste rebondit
Email scraper : ce qu'il renvoie, pourquoi les listes scrapées rebondissent, le nettoyage qui corrige, et un extracteur d'email gratuit pour vos textes.
Dernière mise à jour : 2026-10-13
Un email scraper est un outil qui parcourt des pages web et en extrait toutes les chaînes qui ressemblent à une adresse email. Vous le pointez sur un site, une liste d'URLs ou un annuaire, et il vous rend une colonne d'adresses. C'est rapide, c'est peu coûteux à la ligne, et c'est la façon la plus courante de se retrouver avec une liste qui rebondit.
La confusion qui coûte le plus cher est celle entre un email scraper et un email finder. Les deux termes semblent interchangeables et résolvent des problèmes différents. Ce guide couvre ce que chacun renvoie vraiment, où un scraper va chercher, pourquoi une grande partie de sa sortie est inutilisable en prospection, et comment transformer un scrape brut en liste réellement envoyable.
Si le texte est déjà devant vous (une page copiée, un code source HTML, un export), vous n'avez pas besoin d'un email scraper : il vous faut un extracteur d'email. L'outil gratuit ci-dessous lit ce que vous collez ou déposez, garde toutes les adresses, supprime les doublons et les classe en nominatives, génériques, messageries personnelles et jetables. Il tourne dans votre navigateur et n'envoie rien.
Servez-vous-en comme première étape de la méthode de ce guide : le classement qu'il fait, c'est le tri des boîtes génériques de la passe de nettoyage, appliqué pour vous à un bloc de texte. Quand les adresses sont réparties sur une liste de sites, lisez la suite : c'est le travail d'un vrai email scraper, et le reste de cette page explique comment faire de l'email scraping sans finir avec une liste qui rebondit.
Ce que fait vraiment un email scraper
Un scraper lit le contenu visible et le code source d'une page, et retient tout ce qui a la forme d'une adresse. Il ne sait pas qui est la personne, si la boîte est encore ouverte, ni même si l'adresse appartient à un humain. Il connaît le motif, rien de plus.
Cela compte, parce que la plupart des adresses publiées sur le web ouvert sont volontairement génériques. Les pages contact portent contact@, info@, bonjour@, commercial@, support@. Les pages légales portent privacy@ et dpo@. Ces adresses existent, elles reçoivent du courrier, et elles arrivent dans une boîte partagée qu'un décideur ne lit pas. Un scrape de mille sites d'entreprise renvoie une grosse pile d'adresses et un petit nombre de personnes.
La description honnête est donc la suivante : un email scraper répond à la question quelles adresses sont publiées sur cette page. Il ne répond pas à comment je joins le directeur commercial de cette entreprise. Ce sont deux questions différentes, et elles demandent deux outils différents.
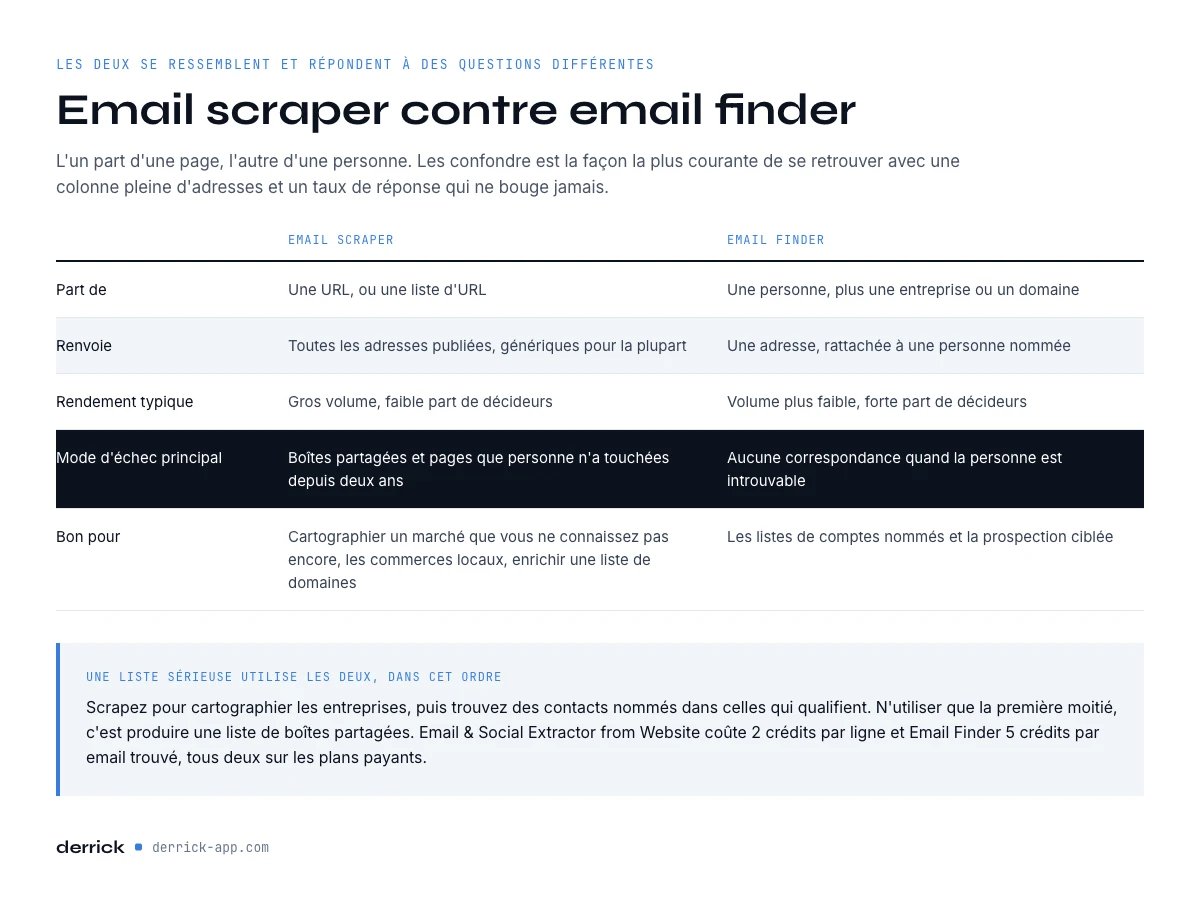
Email scraper contre email finder
Un email finder part d'une personne. Vous lui donnez un nom et une entreprise ou un domaine, il renvoie l'adresse professionnelle de cet individu. C'est le bon outil quand vous savez déjà à qui vous voulez parler.
Un scraper part d'une page. Vous lui donnez une URL et il renvoie ce qui y est publié. C'est le bon outil quand vous voulez tout ce qu'un site expose, numéros de téléphone et profils sociaux compris, et que vous n'avez pas encore de cibles nommées.
| Email scraper | Email finder | |
|---|---|---|
| Part de | Une URL ou une liste d'URLs | Une personne plus une entreprise ou un domaine |
| Renvoie | Toutes les adresses publiées, souvent génériques | Une adresse, rattachée à une personne nommée |
| Rendement typique | Gros volume, faible part de décideurs | Volume plus faible, forte part de décideurs |
| Principal mode d'échec | Boîtes génériques et pages périmées | Pas de correspondance quand la personne est introuvable |
| Utile pour | Cartographier un marché, commerces locaux, enrichir une liste de domaines | Listes de comptes nommés et prospection ciblée |
En pratique, une liste sérieuse utilise les deux, dans cet ordre : scraper pour cartographier les entreprises, puis chercher des contacts nommés dans celles qui qualifient. N'utiliser que la première moitié, c'est produire une liste de boîtes génériques et un taux de réponse qui ne bouge jamais. Pour la partie finder en détail, le guide de recherche d'email de lead la couvre.
Les types d'outils d'email scraping, et ce que chacun renvoie
Les outils d'email scraping prennent quatre formes. Tous reconnaissent le même motif, une chaîne qui a la forme d'une adresse : la différence n'est donc pas dans ce qu'ils repèrent. Elle tient à l'endroit où ils lisent, au nombre de pages qu'ils couvrent, et à ce qu'ils font du résultat.
| Type | Fonctionnement | Ce qu'il renvoie | Limite principale | À utiliser quand |
|---|---|---|---|---|
| Extension de navigateur | Lit la page ouverte dans votre navigateur, parfois les pages suivantes d'une recherche | Les adresses visibles sur les pages que vous visitez | Une page à la fois, au rythme de votre navigation | Vous étudiez quelques sites à la main |
| Script ou code | Un robot que vous faites tourner vous-même, souvent adapté d'un dépôt de code public | Tout ce qu'il peut récupérer, brut, dans un fichier | Vous le maintenez : requêtes bloquées, pages en JavaScript, doublons et analyse sont pour vous | Vous avez un développeur et une source inhabituelle |
| Extracteur d'email en ligne | Vous collez un texte, un fichier ou quelques URLs dans une page web | Une liste dédoublonnée, parfois avec un type par adresse | Listes courtes, aucune vérification de la boîte, un plafond d'URLs par passage | Il vous faut une liste ponctuelle à partir d'un texte que vous avez déjà |
| App qui scrape et vérifie | Prend une colonne de domaines, lit chaque site, puis contrôle les adresses | Adresses et profils sociaux par entreprise, avec un statut de vérification | Payant à la ligne et à la vérification | Vous construisez une liste de prospection sur des dizaines à des milliers d'entreprises |
Les trois premiers s'arrêtent à l'extraction. Cela suffit quand la liste est courte et que vous la nettoyez à la main. Au-delà de quelques dizaines de domaines, ce qui prend du temps n'est pas de trouver les chaînes, c'est tout ce qui suit : dédoublonnage, tri des boîtes génériques, vérification et drapeau catch-all. C'est pour cela que la quatrième catégorie existe, et que ce guide consacre plus de place au nettoyage qu'à l'extraction.
Deux tests rapides avant de choisir l'un de ces outils d'email scraping. Faites-le tourner sur cinq sites que vous connaissez, où vous pouvez vérifier à la main ce qu'il devrait trouver : ce qu'il rate vous en apprend plus que ce qu'il trouve. Ouvrez ensuite l'export : un email scraper qui garde l'URL source de chaque adresse vous fait gagner un après-midi quand vous mesurez les rebonds par source.
Dans l'app web ou Google Sheets
Collecter ce qui est publié, et savoir que c'est cela
Les listes scrapées rebondissent parce qu'on garde tout ce qui a été trouvé. Derrick renvoie les adresses réellement publiées sur le site, dans une colonne de votre liste, que vous pouvez ensuite passer par la vérification avant tout envoi.
- Fonctionnalité
- Extraction d'emails & réseaux depuis un site
- Coût en crédits
- 2 crédits par ligne
Le premier bouton ouvre l'app web (rien à installer) : 2 crédits par ligne, disponible dès le plan STANDARD. Le second détaille la fonctionnalité et son coût par plan.
Les quatre sources dans lesquelles il pioche
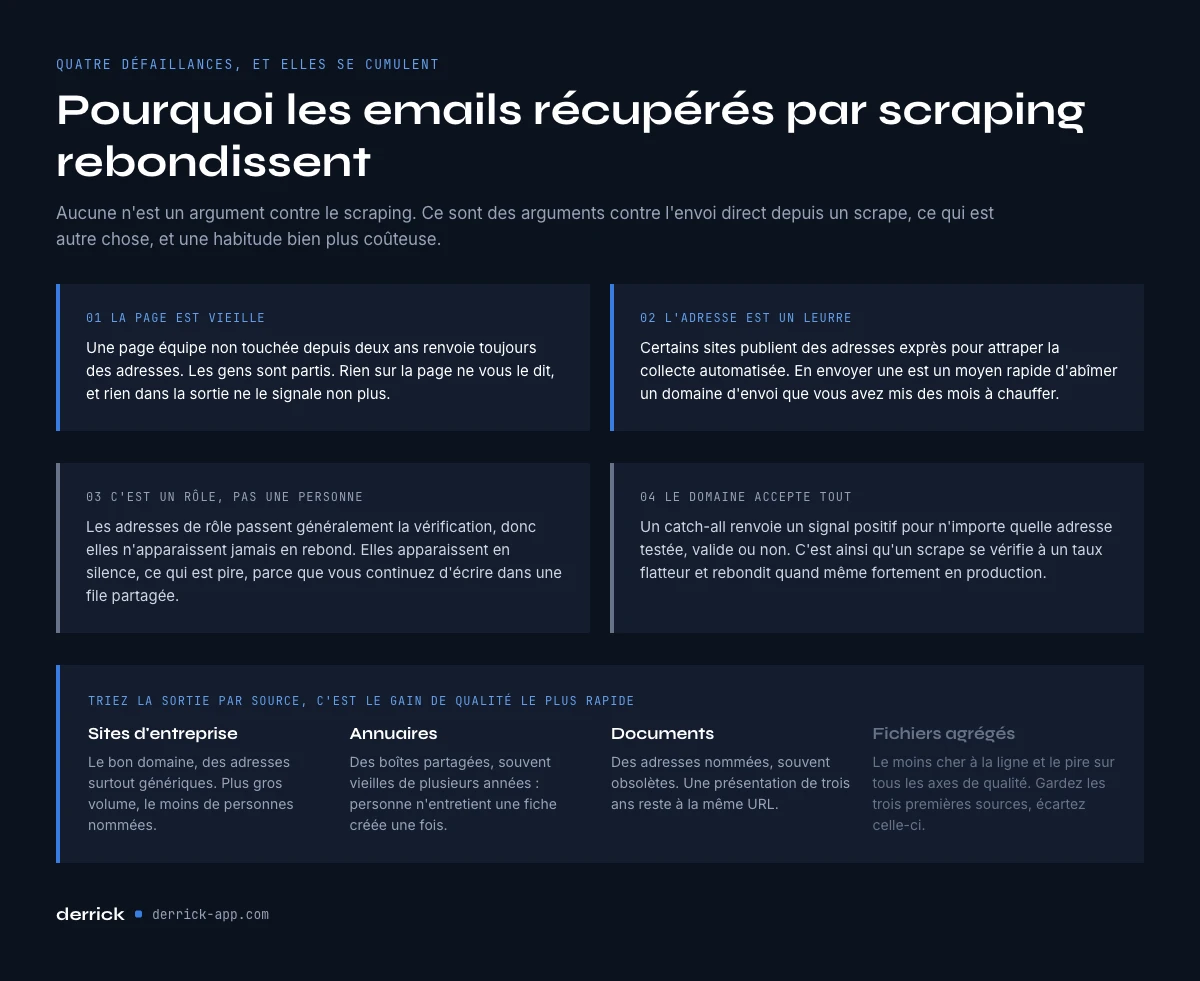
Toutes les adresses récupérées ne se valent pas. Trier la sortie par provenance est le gain de qualité le plus rapide à obtenir.
Les sites d'entreprise. Pages contact, à propos, équipe et mentions légales. Fiables au sens où le domaine est le bon, faibles au sens où les adresses sont généralement génériques. C'est la source au plus gros volume et à la plus faible part de personnes nommées.
Les annuaires et places de marché. Listings locaux, registres d'associations, sites d'avis. L'adresse est souvent une boîte partagée, et elle peut avoir des années parce que personne n'entretient une fiche créée une fois. Google Maps et les autres fiches d'établissements locaux entrent dans ce groupe : la fiche renvoie en général vers le site de l'entreprise, et c'est là que l'adresse se trouve vraiment. Dans l'app web Derrick, le Google Maps Scraper importe les établissements locaux à 1 crédit par lieu, site web compris, pour que l'extraction tourne ensuite sur le résultat.
Les documents. Plaquettes, grilles tarifaires et PDF indexés sur un site. Ils contiennent souvent des adresses nommées, et ils sont souvent obsolètes parce qu'un PDF de trois ans reste à la même URL.
Les fichiers agrégés. Des lots d'adresses collectés ailleurs et revendus. Le moins cher à la ligne et le pire sur tous les axes de qualité. Si vous en envisagez un, l'arithmétique honnête est dans acheter une liste email et ce que ça coûte vraiment.
Une règle pratique : gardez les trois premières, étiquetez-les par source, et mesurez le taux de rebond par source après le premier envoi. Les écarts sont en général assez grands pour changer la façon dont vous dépensez le mois suivant.
Pourquoi les emails récupérés par scraping rebondissent
Quatre choses tournent mal, et elles se cumulent.
La page est vieille. Une page équipe qui n'a pas bougé depuis deux ans renvoie toujours des adresses. Les personnes sont parties. Rien sur la page ne vous le dit.
L'adresse est un piège. Certains sites publient des adresses précisément pour détecter la collecte automatisée. Écrire à l'une d'elles est un moyen rapide d'abîmer la réputation d'un domaine d'envoi.
La boîte est générique, pas personnelle. Les adresses génériques passent souvent la vérification, donc elles n'apparaissent pas du tout comme des rebonds. Elles apparaissent comme du silence, ce qui est pire, parce que vous continuez à envoyer.
Le domaine accepte tout. Un domaine catch-all renvoie un signal positif pour n'importe quelle adresse testée, valide ou non. C'est pour cela qu'un scrape peut afficher un taux de vérification flatteur et rebondir fort en production. Le mécanisme est dans le guide catch-all, et le traitement pratique dans le guide du bounce checker.
Rien de tout cela n'est un argument contre l'email scraping. Ce sont des arguments contre le fait d'envoyer directement depuis un scrape.
L'app lance la recherche ligne par ligne sur votre liste : 2 crédits par ligne.
Limites : volume, pages en JavaScript et emails derrière une connexion
Un email scraper rate des adresses pourtant bien visibles sur une page plus souvent qu'on ne le pense. Cinq causes couvrent presque tous les cas.
- L'adresse est une image. Certains sites publient leur adresse de contact sous forme d'image pour qu'on ne puisse pas la collecter. Pas de texte, rien à reconnaître.
- La page est construite en JavaScript. L'adresse s'affiche dans votre navigateur une fois les scripts exécutés, mais le HTML brut que le scraper télécharge n'en contient que des morceaux. Les outils qui affichent la page en attrapent davantage, et tournent plus lentement.
- L'adresse est derrière un formulaire ou une connexion. Un formulaire de contact n'expose aucune adresse, et les annuaires de membres ne montrent les adresses qu'aux utilisateurs connectés. Cette partie du web n'a pas vocation à être automatisée.
- L'adresse est déguisée. nom [at] entreprise [dot] fr, entités HTML, ou adresse coupée entre deux balises. Un bon outil d'extraction décode les formes courantes ; une phrase écrite pour un humain reste illisible pour un motif.
- Le robot n'a jamais atteint la page. La plupart des scrapers s'arrêtent à une profondeur ou à un nombre de pages fixé par site. Une page équipe à quatre clics de l'accueil, ou un PDF lié depuis une vieille actualité, reste hors du parcours.
Le volume a ses propres limites. Les outils d'email scraping en ligne plafonnent en général le nombre d'URLs par passage, les extensions vont au rythme de votre navigation, et les sites ralentissent ou bloquent un client qui demande trop de pages trop vite. Dès que la liste compte des centaines de domaines, la question devient moins « quel email scraper » que « qui fait tourner le parcours, et chaque adresse garde-t-elle sa source ».
Conséquence pratique : un résultat vide sur un site ne veut pas dire que l'entreprise n'a publié aucune adresse. Vérifiez deux ou trois échecs à la main avant de conclure quoi que ce soit sur un segment.
Faire tourner un email scraper dans l'app web ou un tableur
La version qui résiste au contact d'une vraie liste garde toutes les étapes au même endroit, pour que vous voyiez la perte à chaque palier plutôt que de la découvrir dans vos statistiques de campagne.
Commencez dans l'app web Derrick : importez vos domaines sous forme de liste, ou gardez-les dans une Google Sheet et lancez la même étape depuis la barre latérale Derrick si c'est là que votre équipe travaille. Email & Social Extractor from Website récupère les adresses publiées et les profils sociaux de chaque ligne, à 2 crédits la ligne, directement dans votre liste. Vous avez maintenant la sortie brute avec sa provenance.
Ensuite, séparez les boîtes génériques des adresses nommées. Tout ce qui, avant l'arobase, se lit contact, info, bonjour, commercial, support, admin ou un nom de service part dans un autre seau. Ne le supprimez pas, parce qu'une boîte générique est parfois la seule porte d'entrée d'une très petite structure, mais ne le comptez pas comme un contact.
Puis vérifiez ce qui reste. Email Verification tourne à 1 crédit par email et signale les domaines catch-all séparément, ce qui est ici le drapeau qui compte le plus. Décidez tôt si vous vérifiez à l'import ou à l'envoi, parce que les deux produisent des pertes différentes.
Enfin, comblez les trous. Pour les entreprises qui ont qualifié mais n'exposaient rien d'utile, changez d'outil : identifiez la personne visée et passez par Email Finder, à 5 crédits par email, facturé au résultat trouvé. C'est cette dernière étape qui transforme une cartographie de marché en liste de cibles.
Faites tourner le scrape, la vérification et le finder au même endroit avec Derrick, dans l'app web ou dans Google Sheets. Le plan gratuit vous donne 100 crédits par mois pour découvrir l'app ; l'extraction, la vérification et le finder sont des fonctions payantes, disponibles à partir du plan Standard à 20 € par mois, de quoi faire tourner toute la séquence sur un premier lot avant d'engager un budget plus important. Derrick tourne aussi via un serveur MCP pour les clients IA et via une API REST, donc les mêmes étapes s'intègrent dans un workflow automatisé à n'importe quel volume.
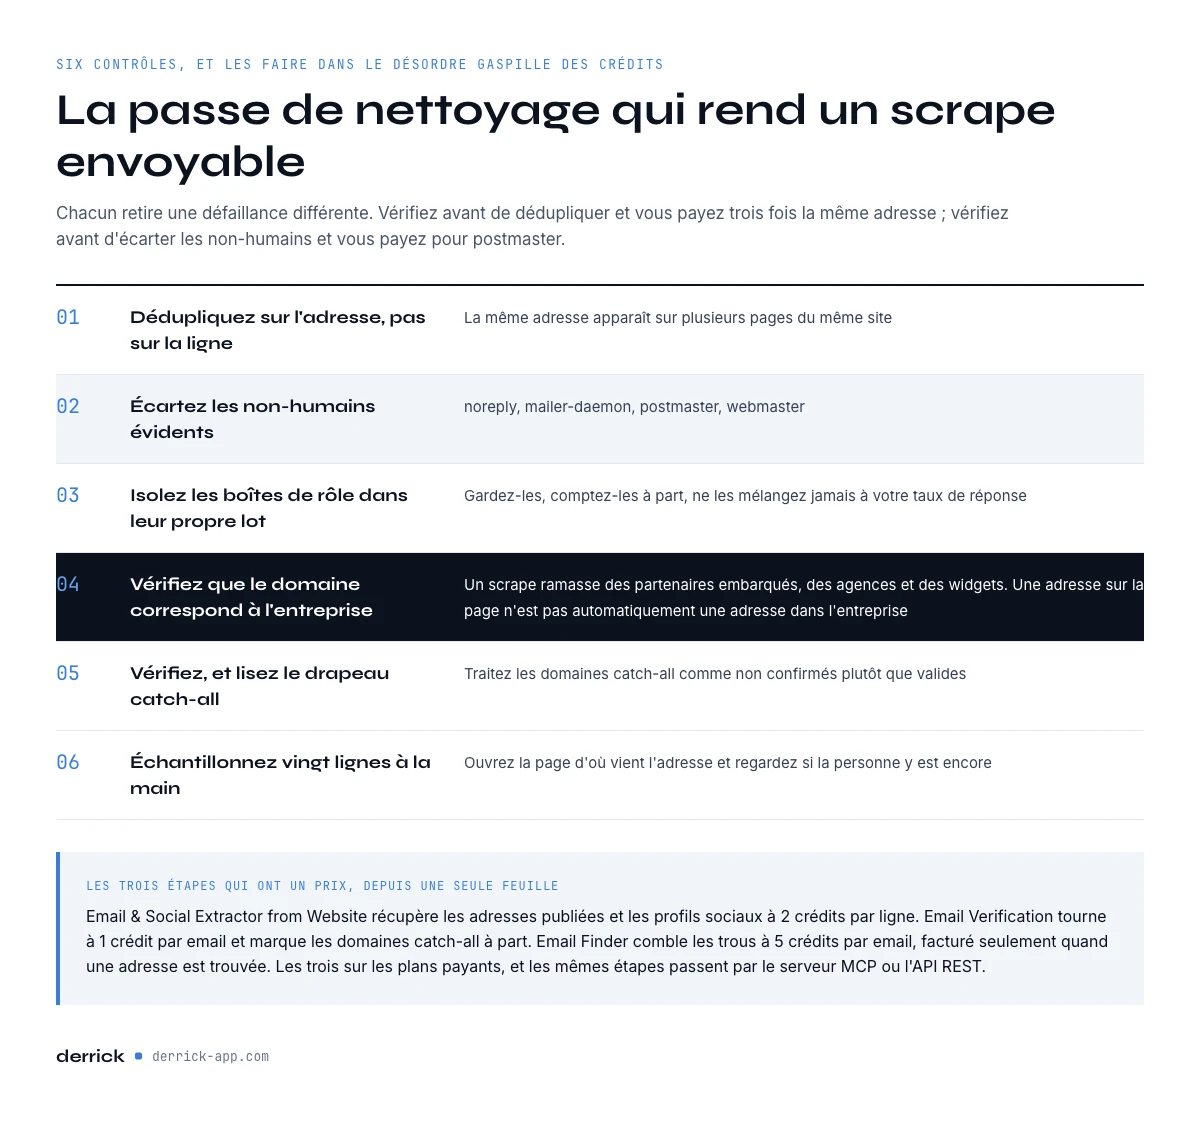
La passe de nettoyage qui rend un scrape envoyable
Six contrôles, dans cet ordre. Chacun retire un défaut différent, et les faire dans le désordre gaspille des crédits.
- Dédoublonnez sur l'adresse, pas sur la ligne. La même adresse apparaît sur plusieurs pages d'un même site. Dans Google Sheets, Find Duplicates, dans la barre latérale Derrick, le fait gratuitement.
- Retirez les non-humains évidents. noreply, no-reply, mailer-daemon, postmaster, webmaster.
- Isolez les boîtes génériques dans leur propre seau. Gardez-les, comptez-les à part, ne les mélangez jamais à votre taux de réponse.
- Vérifiez que le domaine correspond à l'entreprise. Un scrape ramasse aussi les adresses de partenaires, d'agences et de widgets intégrés. Une adresse sur la page n'est pas automatiquement une adresse dans l'entreprise.
- Vérifiez, et lisez le drapeau catch-all. Traitez les domaines catch-all comme non confirmés plutôt que comme valides. Pour une seule adresse douteuse, l'outil gratuit pour vérifier une adresse mail repère les fautes de frappe, les domaines jetables et les adresses génériques avant de payer une vérification de la boîte.
- Contrôlez vingt lignes à la main. Ouvrez le profil, confirmez que la personne est toujours là. Vingt lignes suffisent à distinguer une liste fraîche d'une liste périmée.
Ce qui survit aux six contrôles est un nombre plus petit que ce que le scrape laissait croire, et c'est le seul autour duquel il vaut la peine de planifier une campagne. Pour les repères de ce qui se passe après l'envoi, mesurez le taux de réponse et de rebond par source sur les deux premiers envois.
Quand un email scraper est le mauvais outil
Trois situations où l'email scraping vous coûtera plus qu'il ne rapporte.
Vous connaissez déjà les comptes. Si vous avez une liste de deux cents entreprises cibles et des rôles nommés, un scraper ajoute du bruit. Allez directement au finder sur des personnes nommées ; notre guide pour trouver une adresse email professionnelle part de là.
Votre acheteur est un dirigeant. Les dirigeants ne sont presque jamais l'adresse publiée sur une page contact. Scraper un site de grand compte renvoie la boîte presse et la boîte recrutement. Le guide des emails de dirigeants explique ce qui fonctionne à la place.
Le segment est dense et local. Pour les commerces de proximité, l'information utile est souvent le numéro de téléphone et les horaires, pas une adresse qui aboutit dans une boîte partagée. Scraper le site est le mauvais premier geste quand une fiche établissement porte déjà une donnée mieux structurée.
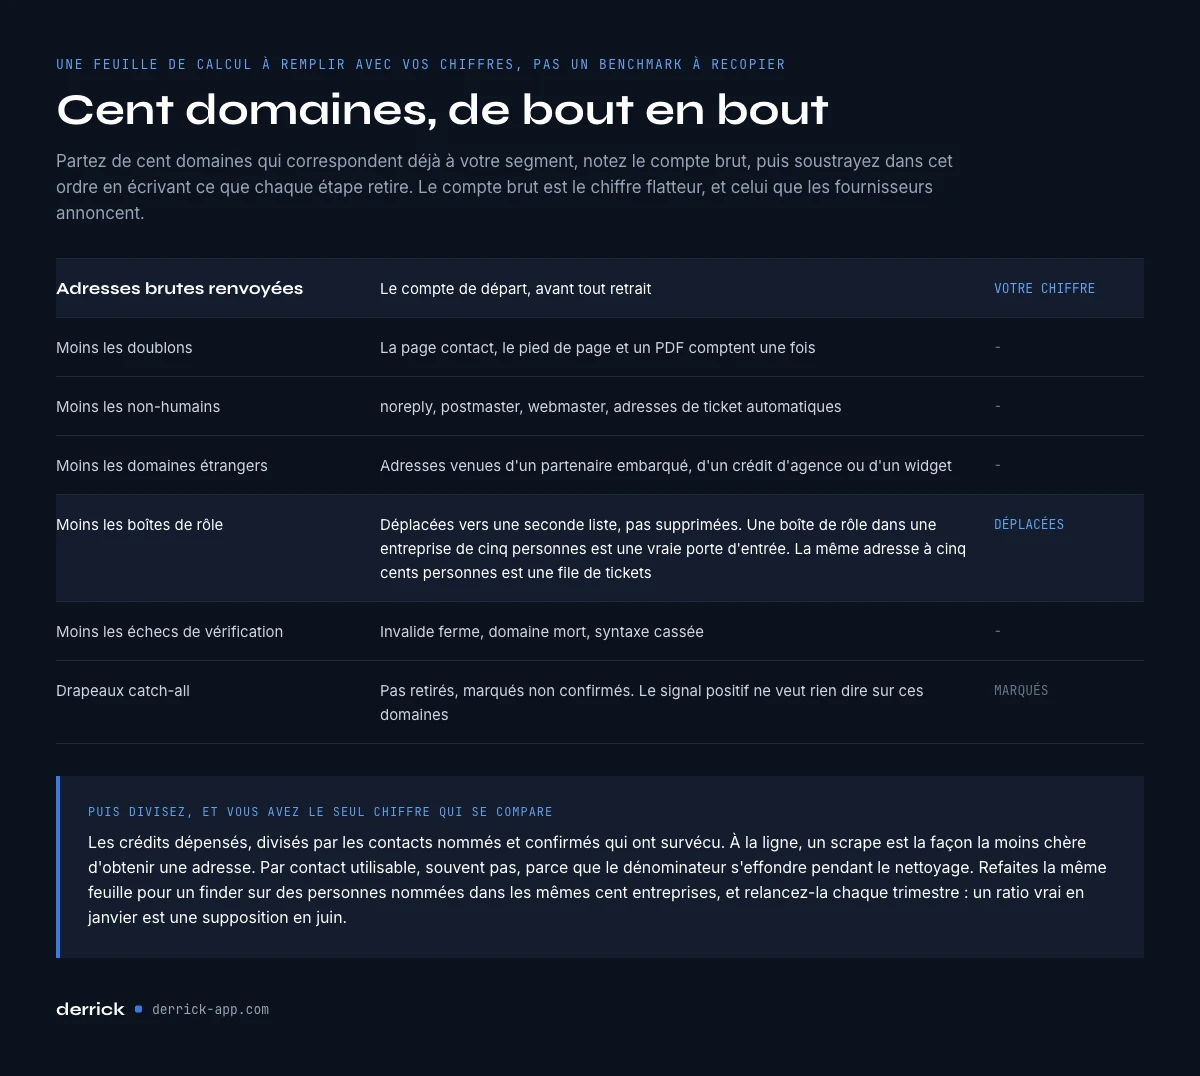
Un exemple chiffré : cent domaines, de bout en bout
La version abstraite s'approuve facilement et s'applique difficilement. Voici la forme de l'entonnoir, écrite comme une feuille de calcul que vous remplissez avec vos propres mesures plutôt que comme un repère à recopier.
Partez de cent domaines d'entreprise qui correspondent déjà à votre segment. Lancez l'extraction et notez le nombre brut d'adresses renvoyées. Ce premier chiffre est toujours le plus flatteur, et c'est celui que les vendeurs citent.
Soustrayez maintenant, dans cet ordre, en notant ce que chaque étape retire :
- Les doublons. La même adresse publiée sur la page contact, dans le pied de page et dans un PDF ne compte qu'une fois.
- Les non-humains. noreply, postmaster, webmaster, adresses de tickets automatiques.
- Les domaines étrangers à la cible. Adresses venues d'un partenaire intégré, d'un crédit d'agence ou d'un widget, qui n'appartiennent pas à l'entreprise que vous scrapiez.
- Les boîtes génériques. Conservées, mais déplacées dans une seconde liste avec ses propres attentes. Une boîte générique dans une structure de cinq personnes est une vraie porte d'entrée. La même adresse dans une entreprise de cinq cents personnes est une file de tickets.
- Les échecs de vérification. Invalides durs, domaines morts, syntaxe cassée.
- Les drapeaux catch-all. Non retirés, mais marqués non confirmés, parce que le signal positif ne vaut rien sur ces domaines.
Ce qui reste, ce sont vos contacts nommés et confirmés issus de cent domaines. Divisez les crédits dépensés par ce nombre et vous obtenez un vrai coût par contact utilisable, sur votre segment, et non sur une étude de cas générique.
Faites ensuite tourner la seconde moitié. Pour les entreprises qui ont qualifié mais n'ont rien donné de nommé, identifiez le rôle visé et cherchez cette personne directement. Notez les deux mêmes chiffres : contacts obtenus et crédits dépensés. Vous tenez alors la seule comparaison qui compte, mesurée sur votre propre marché, et elle vous dira si vos mille lignes suivantes doivent partir de pages ou de personnes.
Gardez la feuille. Rejouez-la une fois par trimestre sur un échantillon frais. Les ratios bougent quand le segment bouge, et un chiffre vrai en janvier n'est plus qu'une supposition en juin.
Le coût par contact réellement utilisable
À la ligne, un scrape est la façon la moins chère d'obtenir une adresse. Par contact utilisable, ce n'est souvent plus vrai, parce que le dénominateur s'effondre pendant le nettoyage.
Faites le calcul sur vos chiffres plutôt que sur ceux d'un vendeur. Prenez cent domaines. Notez combien de lignes le scrape a renvoyées, combien ont survécu au tri des boîtes génériques, combien ont passé la vérification sans drapeau catch-all, et combien correspondent à votre profil client idéal. Divisez le total des crédits dépensés par ce dernier chiffre. Puis refaites l'opération avec un finder sur des personnes nommées dans les mêmes cent entreprises.
La réponse n'est pas toujours la même, et c'est tout l'intérêt. Le scraping gagne en largeur quand vous ne connaissez pas encore le marché. La recherche nominative gagne en profondeur quand vous le connaissez. Faire tourner les deux dans la même feuille, avec le coût visible à chaque étape, c'est la façon d'arrêter de deviner ce que vous payez réellement.
Pour en faire une tâche répétable plutôt qu'un geste manuel, la même séquence tourne depuis votre propre stack via l'API REST.
Questions fréquentes
Qu'est-ce qu'un email scraper ?
Quelle différence entre un email scraper et un email finder ?
Pourquoi les emails récupérés par scraping rebondissent-ils ?
Comment nettoyer une liste d'emails scrapés ?
Peut-on scraper des emails directement dans Google Sheets ?
Un email scraper coûte-t-il moins cher qu'un email finder ?
Quand ne faut-il pas utiliser un email scraper ?
Existe-t-il un email scraper gratuit ?
À lire ensuite
À lire aussi dans ce cocon
Lead Email Finder : le guide complet pour trouver l'email de vos prospects
Lire →
Comment Trouver le Site Web d'une Entreprise : Guide Complet 2026
Lire →
Comment Trouver le Nom d'Entreprise à partir d'une Adresse Email : Guide Complet
Lire →
Exemples d'adresse mail valide : définition et format
Lire →